Fachlich geprüft von Robin Roeder, Geschäftsführer der SCREENUS GmbH · zuletzt geprüft am 23.09.2026.
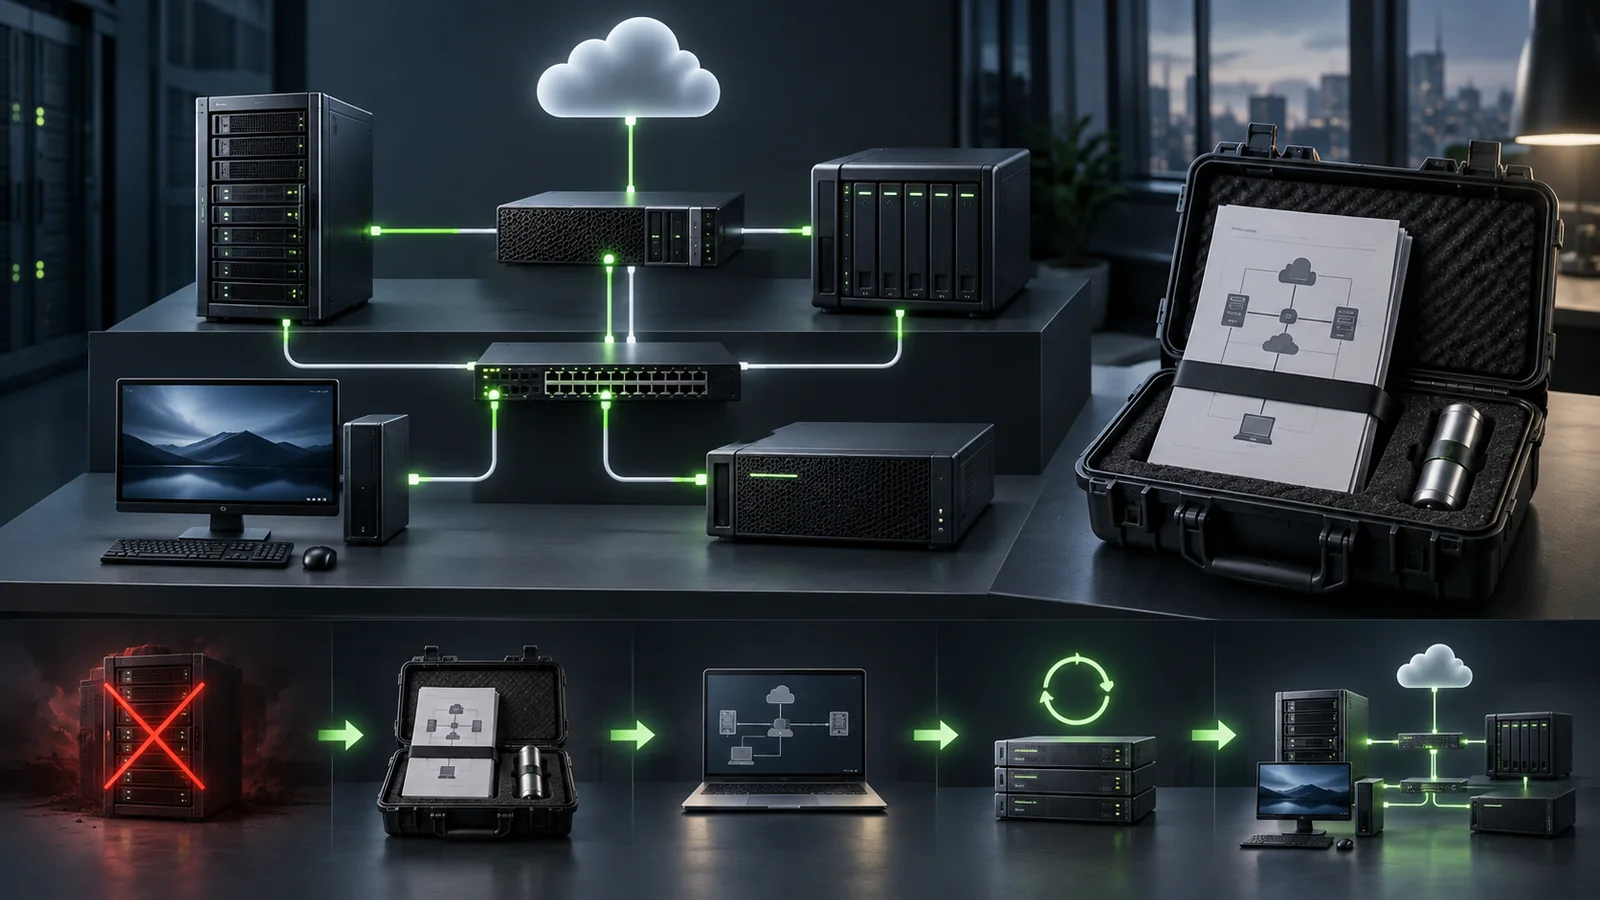
Wenn zentrale Systeme ausfallen, hilft keine Dokumentation, die nur auf genau diesen Systemen liegt. Eine praxistaugliche IT-Dokumentation zeigt in wenigen Minuten, welche Dienste betroffen sind, wovon sie abhängen, wer entscheiden darf, wo geprüfte Sicherungen liegen und wie der Wiederanlauf kontrolliert beginnt. Sie ist aktuell, geschützt und auch dann erreichbar, wenn Netzwerk, Cloud oder Identitätsdienst nicht verfügbar sind.
Dokumentation ist ein Betriebswerkzeug, kein Archiv
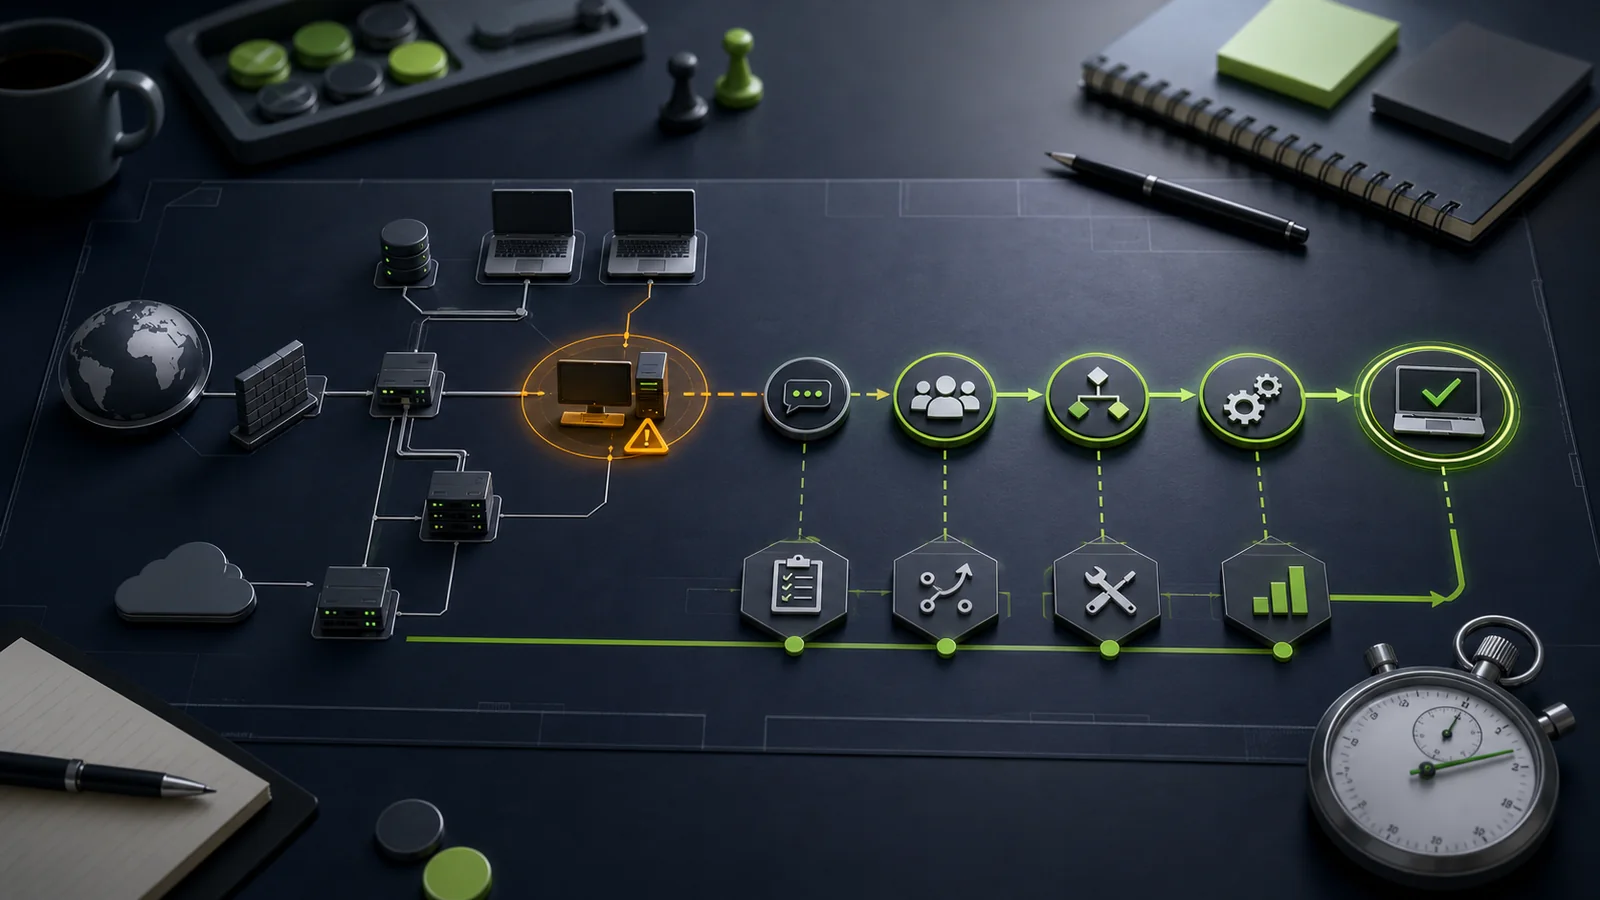
Viele IT-Dokumentationen sind im Alltag kaum nutzbar: Geräte stehen in einer Tabelle, Passwörter in einer zweiten Datei und Netzwerkpläne in einem Projektordner, dessen Besitzer längst gewechselt hat. Im Störungsfall fehlt dann der Zusammenhang. Welche Anwendung benötigt welchen Server? Ist die Anmeldung vom ausgefallenen Identitätsdienst abhängig? Welcher Internetanschluss trägt den Fernzugriff? Welche Sicherung ist für diesen Dienst geprüft worden?
Das BSI empfiehlt für die Erhebung von IT-Systemen eindeutige Bezeichnungen, technische Angaben und eine Darstellung der Beziehungen zwischen Systemen und Anwendungen. Genau diese Beziehungen machen aus einer Inventarliste eine handlungsfähige Betriebsdokumentation. Ein Gerät ohne zugeordneten Dienst, Verantwortlichen und Wiederanlaufweg bleibt im Ernstfall nur ein Name.
Die erste Ebene: Dienste und Abhängigkeiten sichtbar machen
Der Einstieg sollte nicht beim einzelnen Switchport beginnen, sondern bei den Leistungen, die der Betrieb tatsächlich benötigt. E-Mail, Warenwirtschaft, Dateifreigaben, Telefonie, Produktionszugänge oder Stalltechnik werden jeweils mit ihren technischen Voraussetzungen verbunden. So entsteht eine überschaubare Dienstkarte statt eines unlesbaren Gesamtplans.
- Geschäftsdienst benennen. Eine verständliche Bezeichnung beschreibt, was für Mitarbeitende oder Kunden nutzbar sein muss.
- Technische Bausteine zuordnen. Server, virtuelle Maschine, Datenbank, Speicher, Netzwerk, Cloud-Dienst und Endgeräte werden dem Dienst zugeordnet.
- Voraussetzungen markieren. DNS, Identitätsdienst, Internet, Strom, Zertifikate, Lizenzen und externe Schnittstellen werden als Abhängigkeiten sichtbar.
- Ausfallwirkung festhalten. Es wird klar, welcher Prozess stillsteht und welcher zeitweilige Ersatzweg möglich ist.
- Wiederanlaufreihenfolge ableiten. Basisdienste starten vor Anwendungen, die auf ihnen aufbauen.
Die zweite Ebene: pro System nur das dokumentieren, was Entscheidungen ermöglicht
Für jedes relevante System genügt zunächst eine kompakte Systemkarte. Sie enthält eindeutigen Namen, Zweck, Standort beziehungsweise Plattform, verantwortliche Rolle, Hersteller- oder Supportbezug, Netzwerkzuordnung, Wartungsfenster, Sicherungsverfahren und die wichtigsten Abhängigkeiten. Hinzu kommen Hinweise auf die ausführliche Konfiguration – nicht zwangsläufig deren vollständige Kopie.
Konfigurationsdetails können automatisiert aus Management- und Monitoring-Systemen kommen. Entscheidend ist, dass die Quelle benannt und ihr Aktualitätsstand erkennbar ist. Bei virtuellen Maschinen gehören Host oder Cluster, Speicherort und Abhängigkeit von zentralen Verwaltungsdiensten dazu. Bei Cloud-Diensten sind Mandant, Vertragsinhaber, administrative Rollen, Domänenbezug, Exportmöglichkeiten und Supportweg oft wichtiger als eine vermeintliche Serveradresse.
Notfallzugänge sicher vorbereiten
Ein häufiger blinder Fleck entsteht, wenn alle Administrationskonten vom selben Identitätsdienst, demselben Mobiltelefon oder demselben Passwortmanager abhängen. Fällt dieser Baustein aus, kann die technische Umgebung vorhanden sein und trotzdem niemand handeln. Deshalb braucht es wenige, ausdrücklich geregelte Notfallzugänge für zentrale Systeme.
Das Handbuch beschreibt, wo und nach welchem Verfahren ein Zugang erhältlich ist. Es enthält keine Kennwörter im Klartext. Geeignet sind beispielsweise ein besonders geschützter Tresor im Passwortmanagement mit unabhängigem Wiederherstellungsweg oder ein versiegeltes Offline-Verfahren mit klarer Verantwortlichkeit. Nach jeder Nutzung werden Zugangsdaten geändert und die Verwendung protokolliert. Nicht mehr benötigte Notfallkonten werden entfernt.
Offline verfügbar heißt nicht ungeschützt
Der BSI-Standard 200-4 betont zwei Ziele, die zusammengehören: Im Notfall benötigte Dokumente müssen für die vorgesehenen Personen verfügbar sein; zugleich enthalten sie häufig schützenswerte interne Informationen. Eine unverschlüsselte Kopie auf einem beliebigen USB-Stick erfüllt daher nur die Hälfte der Aufgabe.
Praktisch kann das Einsatzpaket verschlüsselt auf einem getrennt verwahrten Datenträger liegen. Eine reduzierte Papierfassung mit Kontakt-, Eskalations- und Startinformationen kann sinnvoll sein, wenn auch Strom und Endgeräte betroffen sind. Vertrauliche Details werden auf das Nötige begrenzt. Jede Kopie trägt Version, Freigabedatum, Eigentümer und nächsten Prüftermin. Veraltete Fassungen werden kontrolliert eingezogen, damit im Stress nicht nach einem überholten Plan gearbeitet wird.
Das minimale Einsatzpaket
Ein kleines oder mittleres Unternehmen kann mit acht klar getrennten Bausteinen starten. Die Tiefe richtet sich nach Größe und Komplexität; das Prinzip bleibt gleich.
- Dienst- und Systemübersicht. Kritische Leistungen, technische Bausteine, Standorte und Abhängigkeiten.
- Wiederanlaufkarten. Pro wichtigem Dienst: Voraussetzungen, Reihenfolge, Prüfschritte, Abbruchkriterien und verantwortliche Rolle.
- Netz- und Zugangsübersicht. Internetwege, zentrale Netzkomponenten, Verwaltungszugänge, Fernzugriff und relevante Segmentgrenzen.
- Backup- und Restore-Übersicht. Sicherungsziele, Aufbewahrung, unveränderbare oder getrennte Kopien, letzter erfolgreicher Wiederherstellungstest.
- Kontakt- und Eskalationsliste. Interne Entscheidungen, IT-Dienstleister, Provider, Hersteller, Versicherung und weitere benötigte Stellen.
- Notfallzugangsverfahren. Fundort, Freigabe, Vier-Augen-Prinzip, Protokollierung und Rücksetzung – ohne Klartextkennwörter.
- Kommunikationsvorlagen. Kurze, vorbereitete Texte und alternative Kanäle für Mitarbeitende, Kunden und Dienstleister.
- Ereignisprotokoll. Zeit, Beobachtung, Entscheidung, Maßnahme und verantwortliche Person werden fortlaufend notiert.
Inventar, Wiederanlauf und Incident Response verbinden
CISA empfiehlt, physische und logische IT-Assets sowie ihre gegenseitigen Abhängigkeiten zu kennen und kritische Systeme für die Wiederherstellung zu priorisieren. NIST behandelt Notfallplanung entsprechend als Kombination aus Plänen, Verfahren und technischen Maßnahmen. Die Dokumentation ist damit keine isolierte Compliance-Aufgabe, sondern verbindet laufenden IT-Betrieb, Backup, Sicherheitsreaktion und Wiederanlauf.
Das zeigt sich besonders bei Cybervorfällen. Eine gute Übersicht hilft, betroffene Systeme einzugrenzen und saubere von möglicherweise kompromittierten Komponenten zu unterscheiden. Sie verhindert aber auch übereiltes Handeln: Wer Abhängigkeiten kennt, schaltet nicht versehentlich den einzigen DNS-Dienst ab, auf den forensische Werkzeuge und Wiederherstellung zugreifen müssen. NIST SP 800-61 Rev. 3 ordnet Incident Response deshalb in das gesamte Cyber-Risikomanagement ein, einschließlich Vorbereitung und Wiederherstellung.
Aktualität organisatorisch erzwingen
Ein jährlicher Kalendereintrag reicht für dynamische Umgebungen selten. Dokumentation bleibt eher aktuell, wenn technische Änderungen automatisch eine kleine Abschlussaufgabe auslösen. Die Änderung gilt erst als beendet, wenn die betroffenen Systemkarten, Pläne und Wiederanlaufhinweise angepasst wurden.
Zusätzlich empfiehlt sich eine vierteljährliche Kurzprüfung der wichtigsten Kontakt- und Zugangsinformationen. Nach realen Störungen oder Übungen werden Unklarheiten direkt in Dokumentation und Ablauf übernommen. NIST SP 800-34 hebt hervor, dass Handlungen und Probleme während Wiederherstellung und Rückkehr zum Normalbetrieb dokumentiert und als Erkenntnisse in die Pläne zurückgeführt werden sollen.
Ein realistischer Lesetest
Die beste Qualitätskontrolle ist eine fachkundige Vertretung, die das System nicht täglich betreut. Sie erhält ein konkretes Szenario: Der Hauptserver ist nicht erreichbar, der übliche Administrator ist abwesend und der Cloud-Zugang funktioniert nicht. Innerhalb von 20 Minuten soll sie anhand der Unterlagen erklären können, welche Dienste betroffen sind, wen sie informiert, welche Beweise erhalten bleiben müssen und welcher Wiederanlaufweg zulässig ist.
Wo nachgefragt, geraten oder ein System erst gesucht werden muss, fehlt eine Verbindung in der Dokumentation. Der Test muss keine technische Wiederherstellung auslösen. Er prüft zunächst Orientierung, Entscheidungsfähigkeit und Zugriff auf die nötigen Informationen. Ein vollständiger Restore- oder Notfalltest bleibt ein eigener, kontrolliert geplanter Schritt.
In 30 Tagen zu einer belastbaren Grundfassung
- Woche 1: Dienste priorisieren. Die wichtigsten Geschäftsleistungen und maximal tolerierbaren Unterbrechungen werden mit den Verantwortlichen geklärt.
- Woche 2: Systeme und Abhängigkeiten verbinden. Vorhandene Inventare werden bereinigt und in eine verständliche Dienstkarte überführt.
- Woche 3: Zugänge und Wiederanlaufkarten erstellen. Notfallzugang, Backup-Quelle, Reihenfolge und technische Prüfpunkte werden festgelegt.
- Woche 4: Offline-Kopie und Lesetest. Das Einsatzpaket wird geschützt bereitgestellt, durch eine Vertretung gelesen und anhand der Rückfragen verbessert.
Dokumentation muss im richtigen Moment funktionieren
SCREENUS verbindet Bestandsaufnahme, Monitoring, Backup, Netzwerk und Wiederanlauf zu einer nachvollziehbaren Betriebsdokumentation. Das Ziel ist keine Sammlung möglichst vieler Seiten, sondern eine belastbare Grundlage für Vertretung, Wartung, Störung und Notfall – regional erreichbar und an der tatsächlich betriebenen Umgebung ausgerichtet.
Managed IT-Service ansehen Backup und Notfallvorsorge IT-Dokumentation besprechen
Quellen und Aktualitätsstand
Die fachlichen Aussagen wurden am 23. September 2026 anhand amtlicher und behördlicher Primärquellen geprüft.
- Bundesamt für Sicherheit in der Informationstechnik: BSI-Standard 200-4 – Business Continuity Management
- Bundesamt für Sicherheit in der Informationstechnik: IT-Systeme erheben und Abhängigkeiten dokumentieren
- NIST: SP 800-34 Rev. 1 – Contingency Planning Guide for Federal Information Systems
- NIST: SP 800-61 Rev. 3 – Incident Response Recommendations and Considerations
- Cybersecurity and Infrastructure Security Agency: #StopRansomware Guide